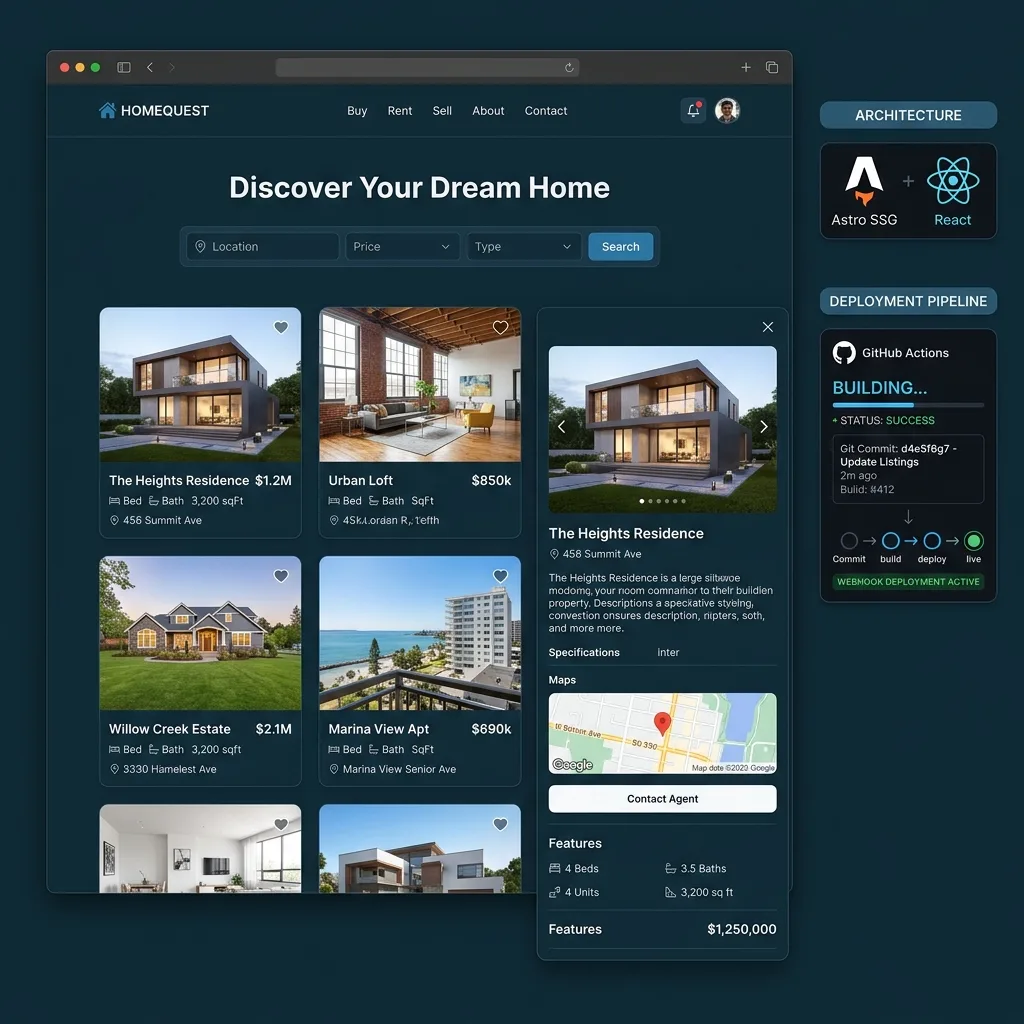
O problema
Precisava de um site que fosse encontrado na busca e, ao mesmo tempo, pudesse ser atualizado por quem não abre editor de código. Página estática resolve a primeira metade e trava a segunda; painel dinâmico resolve a segunda e costuma estragar a primeira.
O que construí
- Páginas estáticas geradas no build para serem indexadas, com aplicação React por cima para a navegação.
- API própria em PHP e MySQL com painel de administração: cadastro de itens com upload de fotos, blog e registro de contatos.
- Publicação sem build manual. Publicar um item no painel dispara um webhook que aciona o GitHub Actions, que reconstrói as páginas estáticas e envia por FTP. Ninguém precisa saber que existe um build.
- Endpoint público de catálogo, hoje consumido por outro sistema meu, o CRM, que espelha os itens em vez de manter um cadastro paralelo.
Decisões técnicas
Correção de orientação de imagem no upload. Fotos de celular guardam a rotação em metadado EXIF. A biblioteca de redimensionamento ignora esse metadado, então as miniaturas saíam deitadas mesmo com o original aparentando estar certo no computador. A correção gira os pixels conforme o EXIF antes de redimensionar, cobrindo os oito casos possíveis, e regrava sem o metadado. Também escrevi um script de manutenção idempotente para corrigir o que já estava no servidor.
Um cadastro só, com contrato explícito. Quando o CRM precisou dos mesmos itens, a saída fácil era duplicar a tabela. Em vez disso, o endpoint público virou contrato: o item se cadastra no site e o CRM apenas lê. Mudar nome de campo ali quebra o outro sistema, e isso está escrito na documentação dos dois lados, porque a segunda fonte de verdade só cobra o preço meses depois.
Como verifiquei
Diagnóstico de performance com número, não com palpite. A queixa era “o site parece lento”. Medindo a página de um item, eram cerca de 4,3 MB de JavaScript, e a maior parte disso era um compilador rodando no navegador para transformar o código a cada visita: a página só ficava interativa uns quatro segundos depois de carregar. Separei em duas causas por impacto e ataquei a menor primeiro, porque era a de risco baixo: as páginas internas carregavam a versão de desenvolvimento da biblioteca em vez da de produção. Trocar cortou cerca de 1 MB por página e foi verificado ao vivo no navegador, com a página montando certa e sem erro no console.
A correção definitiva é a outra, compilar no build e remover o compilador do navegador, e ela está planejada e ainda não entrou. Registro assim porque medir e priorizar não é o mesmo que ter resolvido, e o ganho estimado só vale quando estiver no ar.
O incidente, e o resíduo que a primeira limpeza não pegou. O site sofreu defacement por comprometimento da conta de hospedagem compartilhada, através de sites de terceiros abandonados na mesma conta, não pelo código do site. A resposta está documentada no repositório: identificação do vetor, rotação de todas as credenciais, redeploy limpo, varredura e remoção dos arquivos maliciosos e endurecimento de cabeçalhos.
Semanas depois, olhando as métricas de busca, encontrei resíduo do mesmo ataque: uma pasta que respondia uma coisa para o robô do buscador e outra para o visitante, e que já vinha injetando URLs de spam no índice desde antes do defacement aparecer. Foi tratada com resposta explícita de conteúdo removido e pedido de remoção no console de busca. A lição que ficou não é técnica: “limpo” precisa ser verificado com evidência, não presumido porque o sintoma sumiu.